
En un contexto donde las cargas de trabajo de aprendizaje automático están alcanzando niveles sin precedentes, los desarrolladores han comenzado a crear núcleos de procesamiento específico para Tensor Processing Units (TPU) utilizando frameworks como Pallas, Mosaic y Triton. Sin embargo, este avance en la personalización del hardware trae consigo un desafío significativo: los puntos ciegos de optimización. Para los perfiles de rendimiento tradicionales, las rutas de compilación personalizadas son vistas como caminos de ejecución opacos, lo que pone a los desarrolladores en la difícil situación de trabajar con bloques de ejecución masiva en sus capturas de trazas, sin visibilidad granular sobre lo que realmente ocurre dentro de los componentes internos del chip.
El perfilado tradicional se apoya en modelos de costos estáticos en tiempo de compilación para estimar la eficiencia de los núcleos. Aunque útiles para operaciones estándar, estos modelos no pueden capturar las realidades dinámicas de ejecución en tiempo de ejecución, como bloqueos de instrucciones, congestión en el subsistema de memoria o conflictos en la programación del hardware.
En respuesta a estas limitaciones, se introduce el Kernel Profiling suite dentro de XProf, una suite de depuración de hardware de bajo nivel diseñada específicamente para la autoría y optimización de núcleos sobre TPUs de Google. Al combinar el seguimiento de compilación estático con la telemetría de hardware dinámica y en sub-microsegundos, XProf Kernel ofrece la transparencia requerida para optimizar cargas de trabajo de aprendizaje automático a gran escala.
El primer paso en la depuración de cualquier núcleo personalizado es comprender cómo el compilador traduce el código de alto nivel. Anteriormente, las llamadas personalizadas dentro de los gráficos de optimización de alto nivel (HLO) permanecían completamente ocultas. La nueva versión del Graph Viewer de XProf resuelve este problema exponiendo la lógica interna de compilación directamente. Esto proporciona a los desarrolladores la capacidad de verificar de inmediato si el compilador está fusionando correctamente las operaciones y estructurando los bloques de memoria como se pretende.
Para además brindar visibilidad a nivel de ciclo de ejecución, XProf expone datos de operaciones de bajo nivel (LLO) directamente en el Trace Viewer. Un paquete de LLO representa las instrucciones de máquina reales que se emiten a las unidades funcionales del núcleo del TPU durante cada ciclo de reloj. La instrumentación dinámica de XProf permite insertar marcadores de hardware exactamente en el momento que una región de paquete LLO se ejecuta, permitiendo una alineación temporal precisa de la utilización de métricas de slot del paquete TPU mediante análisis estático.
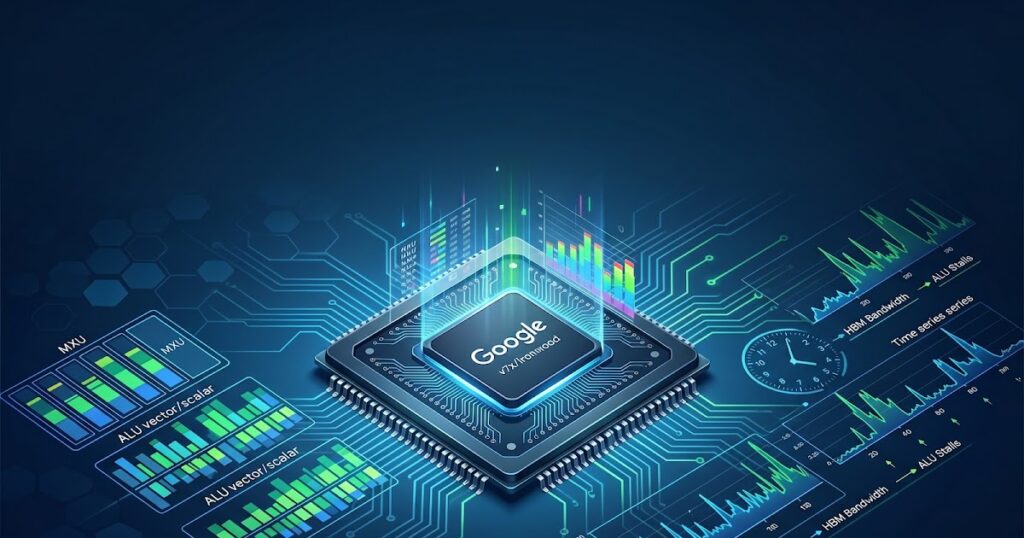
Con la capacidad de muestreo de contadores de rendimiento en tiempo de ejecución de grano fino, disponible a partir de la TPU v7 (Ironwood), los desarrolladores pueden ir más allá de las estimaciones estáticas y medir cómo se utilizan realmente los bloques de hardware en tiempo real. Ejemplos concretos, como la optimización de un núcleo de multiplicación de matrices con azulejos, demuestran que al implementar técnicas de búfer triple, se pueden reducir significativamente los tiempos de ejecución, validando las estrategias de optimización.
El objetivo general de estas mejoras es proporcionar a los desarrolladores las herramientas necesarias para maximizar la densidad de cálculo y mejorar así la eficiencia de las TPUs. Al comparar la línea de tiempo estimada versus la real, XProf permite a los desarrolladores detectar operaciones que podrían estar obstaculizando el rendimiento óptimo y ajustar en consecuencia las formas de datos, alineaciones de memoria y secuencias de instrucciones.
Para desarrolladores interesados en aprovechar estas capacidades avanzadas de XProf para mejorar el rendimiento de sus cargas de trabajo de aprendizaje automático, se recomienda explorar recursos y ejemplos abiertos disponibles, que facilitan la transición de la estimación de desempeño a la medición y optimización de los límites físicos del silicio.
vÃa: Google Blog Open Source