
Hoy, la comunidad tecnológica recibe con entusiasmo el lanzamiento del XLA Serving Engine (XSE), un motor de exportación e inferencia de modelos abierto al público bajo la licencia Apache 2.0. Este proyecto, que forma parte del ecosistema OpenXLA, busca revolucionar la manera en que se implementan los modelos de aprendizaje automático al introducir un flujo de trabajo que permite entrenar modelos en Python y servirlos en C++, adaptándose a las necesidades de producción que limitan el uso de Python debido a su complejidad operativa.
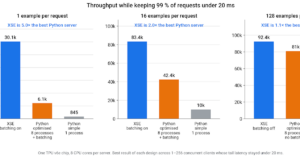
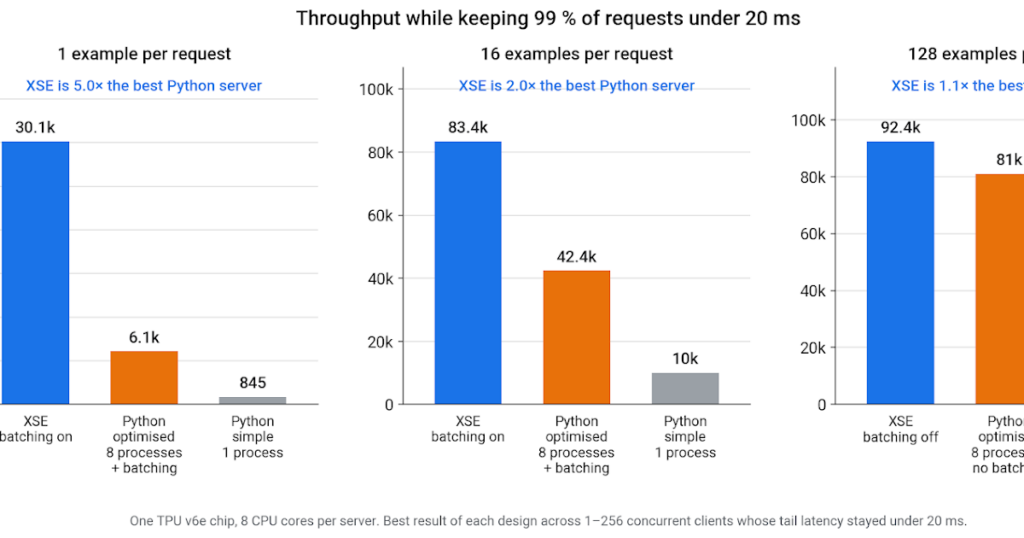
El XSE ofrece una solución innovadora al permitir a los ingenieros de ML exportar sus modelos a un «XLA SavedModel». Este formato, que encapsula la representación de funciones del modelo mediante StableHLO, es compatible con el entorno de ejecución de XLA Serving, posibilitando así una ejecución directa en tiempo de ejecución C++. Este enfoque optimiza el rendimiento, reduciendo significativamente la latencia y el uso de recursos en comparación con los servidores basados en Python. En pruebas internas, por ejemplo, XSE ha mostrado ser entre 2 y 5 veces más eficiente que el mejor servidor Python optimizado disponible, utilizando hasta un 70% menos de tiempo de CPU por predicción.
Desde el año pasado, Google ha integrado componentes clave de XSE en su infraestructura de servicio de producción, logrando procesar más de 6 millones de consultas por segundo en plataformas como YouTube Shorts, Google Ads y Google Search. Este éxito ha preparado el camino para ofrecer XSE a un público más amplio, incluyendo socios de hardware y usuarios de Cloud TPU, lo que permitirá a las organizaciones desplegar este motor de inferencia modular de forma independiente o como parte de una solución más compleja.
Entre las características destacadas de XSE se encuentran su capacidad para operar sin Python, su ejecución de baja latencia y su integración con el sistema de puntos de control Orbax, lo que garantiza paridad de rendimiento con el entorno de entrenamiento original del modelo. Además, se han desarrollado imágenes Docker verificadas en CPU, GPU y TPU, facilitando la implementación ágil de modelos mediante APIs gRPC.
Algunas empresas han comenzado a aprovechar las capacidades del XSE en producción. Arm, por ejemplo, ha demostrado la viabilidad de JAX y XLA en CPUs basadas en Arm Neoverse, mientras que Intel ha mostrado el poder del XSE en sus procesadores Xeon. Moloco, por su parte, utiliza este motor para escalar sus plataformas de publicidad hasta 10.5 millones de solicitudes por segundo.
Mirando hacia el futuro, el XSE planea integrar soporte para TorchTPU, desarrollar la compilación AOT para reducir el tiempo de inicio en frío y ofrecer un preprocesador de datos basado en C++. Sin embargo, reconoce las limitaciones inherentes al no estar optimizado para grandes modelos de lenguaje autoregresivo.
La llegada de XSE al mercado promete potenciar las capacidades de inferencia en la nube y en la periferia, proporcionando un entorno eficiente y adaptado a las complejas necesidades de las cargas de trabajo actuales. ¿Estás listo para optimizar tu pipeline de producción con JAX y XSE?
vÃa: Google Blog Open Source