
El proyecto Apache Iceberg ha lanzado la versión 1.11.0, introduciendo una serie de mejoras significativas que prometen optimizar considerablemente los flujos de trabajo de sus usuarios. Este lanzamiento destaca por su soporte ampliado para Apache Spark 4.1 y Apache Flink 2.1, haciendo de estos las herramientas de construcción predeterminadas. Además, se han implementado cambios estructurales que buscan mejorar la eficiencia y seguridad de las operaciones.
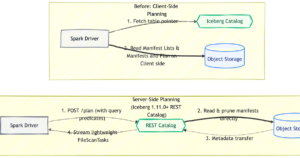
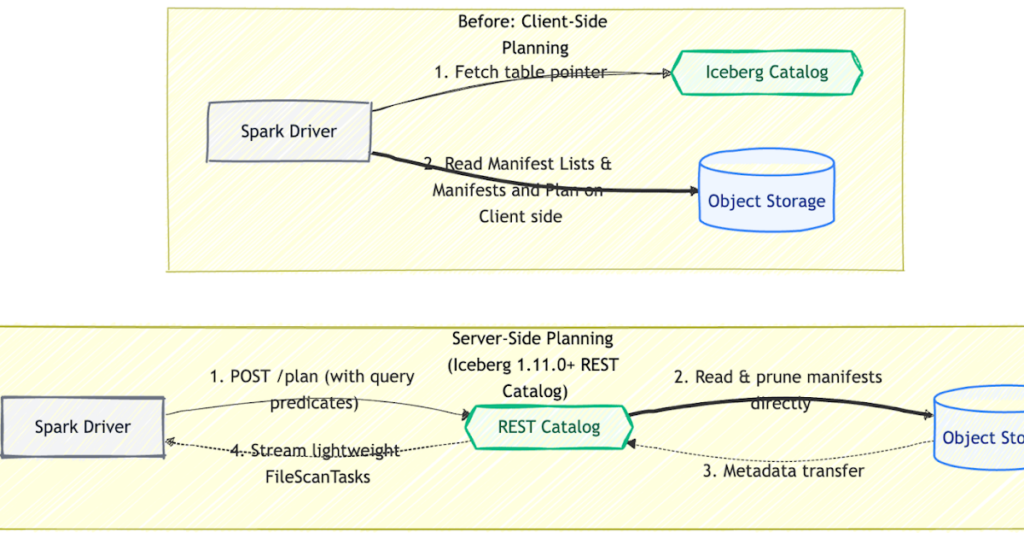
Entre las novedades más destacadas se encuentra la planificación de escaneos del catálogo en el lado del servidor. Esto significa que el motor de consulta ya no se encarga de gestionar la pesada carga de la orquestación de escaneos; en cambio, se ha trasladado este trabajo al catálogo. Este cambio no solo optimiza el proceso, sino que también sobrecarga menos al motor de consultas, permitiendo resultados más eficientes.
Asimismo, Iceberg introduce el cifrado incorporado de tablas, una medida que asegura una protección granular mediante la encriptación y el soporte de Google KMS. Esta característica es especialmente relevante para la gestión de datos sensibles, ya que proporciona capacidades robustas para la seguridad y el cumplimiento normativo. A través de una arquitectura de cifrado escalonada, se asegura la protección completa de los datos almacenados.
Otro cambio significativo es la integración de la biblioteca de Google Storage Analytics, que proporciona un importante aumento de rendimiento para los usuarios de Google Cloud. Esta integración mejora la velocidad de procesamiento y reduce la latencia de análisis de metadatos, optimizando las operaciones de lectura y escritura de archivos almacenados.
La versión 1.11.0 también presenta actualizaciones en los ecosistemas de Spark y Flink. Para Spark, el nuevo soporte de ‘MERGE INTO’ con evolución automática de esquemas destaca, mientras que en Flink, se ha implementado el ‘DynamicIcebergSink’, un sumidero experimental que flexibiliza el direccionamiento de registros en tiempo real. Además, el soporte de nuevos tipos de datos como ‘nanosegundo’ y ‘variable’ refuerza la promesa de Iceberg de ofrecer capacidades de transmisión de baja latencia de primer nivel.
El lanzamiento no solo se ha centrado en la optimización de rendimiento y seguridad, sino que también ha trabajado en mejorar la estructura interna con la introducción del API de Formatos de Archivo. Esto proporciona una mayor coherencia al manejar distintos formatos de archivo, facilitando la integración de nuevos formatos en un futuro.
Finalmente, para aquellos que buscan comenzar con la versión 1.11.0, se recomienda actualizar las dependencias de construcción a la nueva versión y revisar la compatibilidad con JDK 17. La comunidad de Apache Iceberg continúa comprometida con la innovación y el desarrollo de soluciones que respondan a las necesidades cambiantes de sus usuarios.
vÃa: Google Blog Open Source