
Cada segundo, las contribuciones de código abierto dan forma silenciosa al software del que dependemos, y sin embargo, nuestra visión de este ecosistema abierto es sorprendentemente opaca. El desarrollo de código abierto se lleva a cabo en espacios públicos: podemos ver los commits, problemas y comentarios, las APIs y puntos de conexión están libres para uso, y los registros están ahí, al alcance de todos. Entonces, ¿por qué es tan difícil recopilar todos estos datos? Esta es una pregunta que se hacen los investigadores en todo el mundo. Sin embargo, en la mayoría de los casos, los datos relacionados con el código abierto suelen ser solo una parte del todo.
Escribo sobre este tema porque muchos de nosotros, incluidos los responsables de tomar decisiones empresariales, estamos demasiado cómodos con datos no justificados. Nos hemos acostumbrado a esto. Nuestros modelos asumen que son defectuosos y ajustamos la lógica y los pesos para compensar. Al tratarse de código abierto, nuestra confianza es aún menor, a pesar de que nuestras decisiones pueden impactar directamente a las personas de las que colectivamente dependemos.
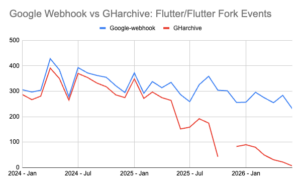
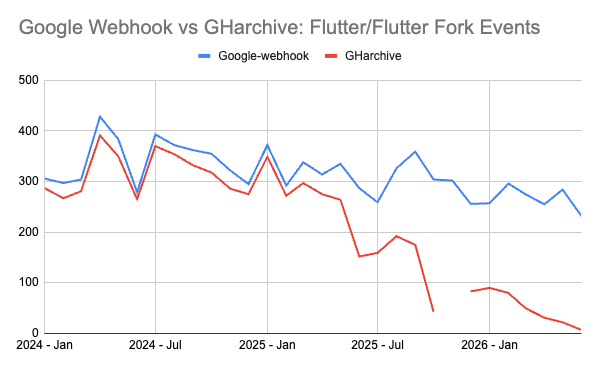
Consideremos uno de mis conjuntos de datos favoritos: GHarchive. Comenzado como un proyecto personal en 2011, este recopilador ha recolectado más de 15 años de datos de eventos de GitHub. Aunque provee un registro histórico del desarrollo de código abierto en GitHub, como fuente en tiempo real o como fuente exhaustiva de métricas, es poco fiable y no debería ser usada para métricas basadas en volumen. En 2025, GHarchive capturó un 14% menos de eventos que en 2024, a pesar de un crecimiento constante en la adopción de la plataforma. Desde 2025, se estima que la retención de datos en GHarchive ha bajado a un 50% y en 2026 podría ser tan baja como un 20% para algunos tipos de eventos.
El código detrás de este conjunto de datos es simple: recaba todos los eventos del flujo de eventos de GitHub (como la apertura de pull requests, comentarios en issues, etc.). Sin embargo, la API de GitHub tiene limitaciones sobre el número de llamadas por hora, así como el número de eventos listados, así que, en días de mucha actividad, se perderán algunos datos. Aunque nunca asumimos que este conjunto de datos recopilaba el 100% de los eventos, la arquitectura actual muestra señales de tensión, quizás debido al crecimiento de los repositorios y la adopción de herramientas automáticas en GitHub. En 2011, GitHub anunció que había alcanzado 2 millones de repositorios públicos, y para 2026, esa cifra superó los 400 millones.
Reconozco que construir y compartir conjuntos de datos abiertos a gran escala es difícil. Imagina descubrir que las variables cambian a mitad de año, que la carga de salida se trunca, que tus uniones se rompen porque un lado del conjunto es sensible a mayúsculas… Estos son problemas de datos comunes. Cuando se construye un conjunto de datos del tamaño de GitHub, surgen nuevos desafíos. En mi propia experiencia con los datos relacionados con código abierto, siempre cuestionaba cuánto podía confiar en nuestras métricas.
Unirme a Andrew Nesbitt, quien ha pasado años analizando datos para el beneficio de la comunidad, amplió mi comprensión de estas limitaciones. Nos dimos cuenta de que a menudo asumimos problemas en la recopilación de datos al trabajar con herramientas como Grimoire labs y OSS insights, que requieren procesos múltiples para recopilación y reconciliación. Aun con estos enfoques, hay fuentes con información incompleta o incoherente.
Una fuente probablemente no sea suficiente. Al considerar el uso de un proyecto de código abierto, convendría saber cuántos mantenedores trabajan en él, las versiones disponibles y cualquier vulnerabilidad activa o problema conocido. Cada consulta requiere una fuente distinta.
Además, no hay una manera consistente de compartir actualizaciones entre plataformas. Para mantener la información actualizada, se escriben procesos de sincronización múltiples que identifican o infieren actualizaciones necesarias. Una petición común es poder «hacer crawling de un punto de acceso que tenga solo cosas NUEVAS».
El diseño de la infraestructura de datos depende del caso de uso. Con modelos lingüísticos grandes (LLMs), es más fácil que cualquiera lleve a cabo informes rápidos sin necesidad de ser exhaustivo, algo donde las fuentes agregadas como GHarchive prosperan. Como proveedores de datos, nos encantaría que los consumidores entendieran la importancia del tipo de colección de datos.
Finalmente, los conjuntos de datos relacionados con código abierto están llenos de información identificable personalmente (PII). Es crucial manejar estos datos con cuidado: anonimizar cuando sea posible y asegurarse de cumplir con políticas y regulaciones. Las comunidades de código abierto son personas reales, por lo que se debe consumir su información de manera responsable.
Interpretar datos sigue siendo crucial, pues los sistemas de IA dependen de ellos. Aunque nuestros datos sobre código abierto continuarán siendo incompletos e imperfectos, al cuestionar nuestras fuentes y considerar los procesos tanto técnicos como humanos detrás del desarrollo de código abierto, podemos mejorar la manera en que interpretamos nuestros análisis y modelos.
vÃa: Google Blog Open Source